 嫁ちゃん
 わたし
嫁ちゃん
わたし
クラウドの波から一歩引いて、息を吸い直す #
世の中は、すっかり「AI一色」になった。
スマートフォンの画面を開けば、毎月数千円と積み上がるサブスクリプションの案内や、「業務効率が劇的に上がる」といった言葉が飛び交っている。確かにクラウドのAIはとても賢くて、どんな問いかけにも即座に答えを返してくれる。
AIの進化の速さには、正直なところ戸惑いを感じることもある。けれど、かつて『攻殻機動隊』の世界で見たような近未来が、すぐそこまで近づいているのだと思うと、どこか胸が高鳴るようなワクワクした気持ちも拭えない。
クラウドAIが嫌いなわけではない。けれど、すべてを外側に委ねて固定費を払い続けることには、少しばかり慎重になっている。そこで私は、お気に入りのクラウドAIを司令塔として据えつつ、定型的な作業や長文の下処理といった手間のかかる仕事は、手元のローカルLLMに任せる形をとっている。
仕事をうまく分けられれば、有料トークンの節約につながる。クラウドへ送る情報を選べるので、データの扱いも自分で考えやすくなる。
M6MacMini32GB、ちょうどいい「小さな工房」 #
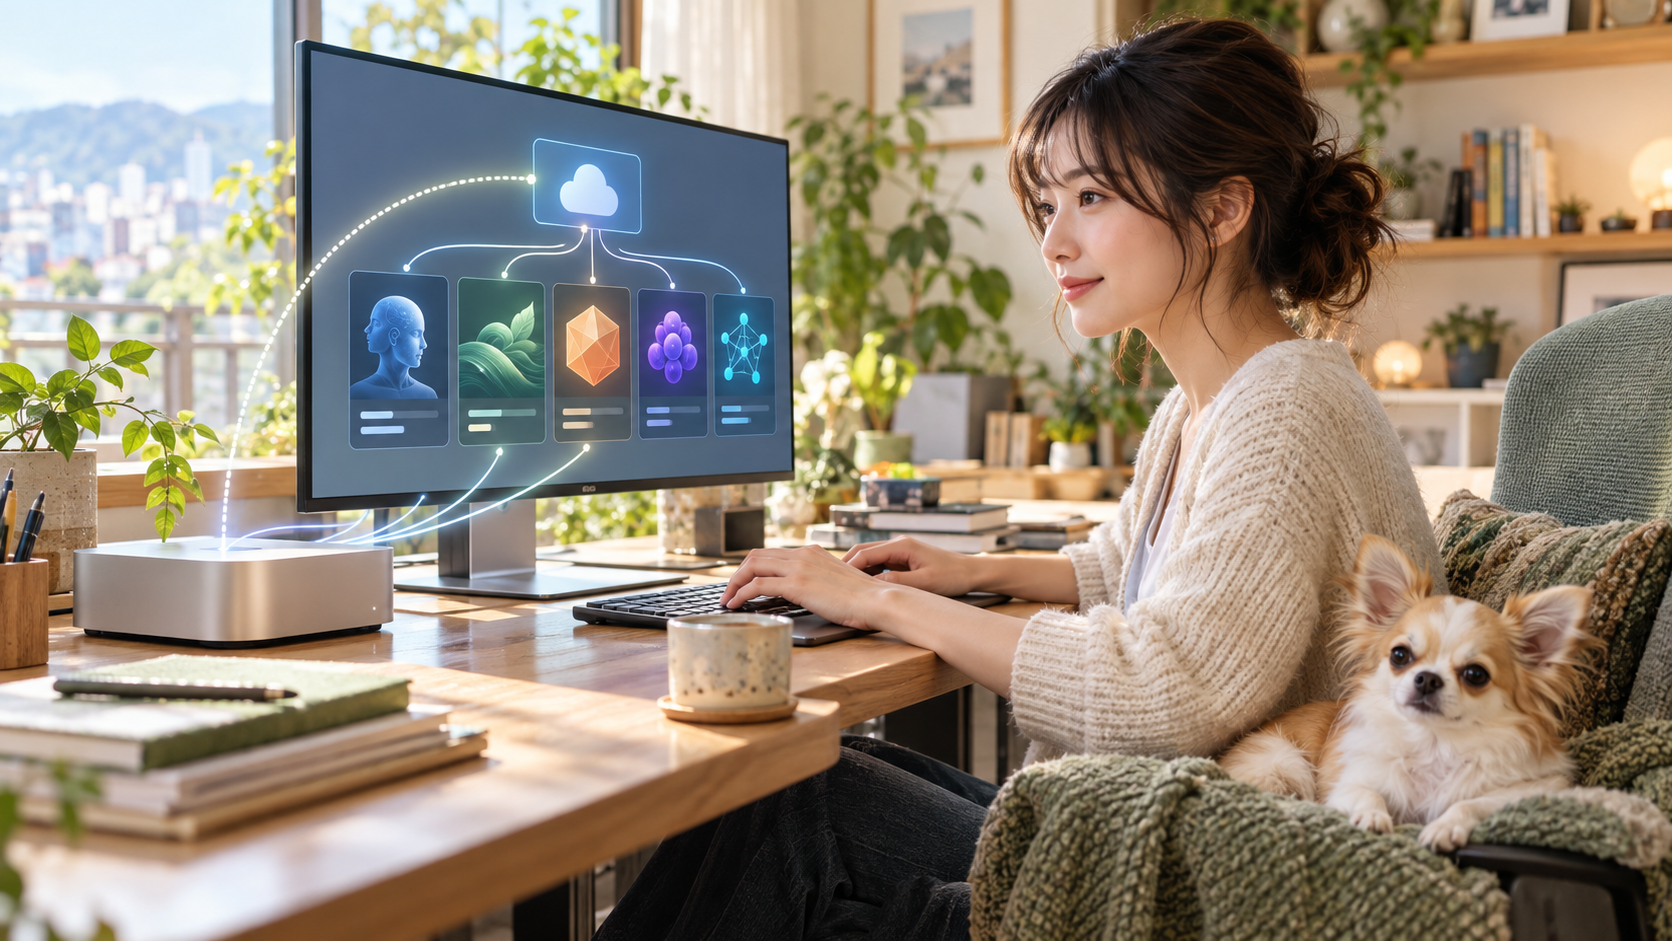
ローカルAIと聞くと、巨大なサーバーが必要な専門家の世界のように思われがちだが、Apple Siliconを搭載したMac、特にユニファイドメモリが32GBある環境なら、話はまた違ってくる。
前に使っていたMac miniはメモリが16GBだった。GPT-OSS 20Bが公開されたとき、「これなら自分でもローカルAIが動かせるかも」と期待してダウンロードしてみたけれど、まともに動かず、ただただ悔しい思いをした。今回のM6 Mac miniでは、本当は64GBモデルが欲しかった。けれど、価格が跳ね上がってしまうので、今回は32GBを選んだ。決して安い買い物ではないけれど、自分の用途にはこれで十分だ。

「Ollama(オラマ)」という無料の道具をひとつMacに入れてやるだけで、机の上のMacがそのまま「私だけの工房」に早変わりする。
最近の私の習慣は、YouTubeやLLMのニュースを見て「あ、これ良さそうな新しいモデルだな」と思ったら、すぐに試してみることだ。AIエージェントを使って複数のモデルに同じ仕事をさせ、それぞれの得意な作業を見極めていく。
「このモデルは要約が丁寧やな」「こっちは指示への忠実さが高いな」と、実際に動かしながら、どのモデルをどの実務に回すか、役割を整えていく。
記事の先頭にある工房の画像はChatGPTで生成したものだ。実写のようでありながら、どこか本物ではないような感覚がある。一方で、見出し「道具に油を差したら…」の下にある画像は、Mac上のDraw Things CLIを使い、ローカル・オフラインで生成した。以前はFLUX.2 Klein 4B Q6Pも試したが、今後はZ Image Turbo 1.0 6B Q6Pを使う。ローカルなら外部サービスの生成枠を気にせず、納得がいくまで繰り返せるのが嬉しい。
生成設定は1280×768、8 stepsで、モデル読み込みを含めて約58秒。画像モデルは約4.87GB、Qwen 3 VL 4B Q8Pのテキストエンコーダは約4.54GB、FLUX VAEは約168MBだ。Ollamaの文章用LLMとは別の画像生成モデルで、クラウドAPIや有料トークンは使っていない。
それはまるで、新しい道具を揃えて、自分なりの使い勝手を研ぎ澄ませていく「手仕事」の営みに似ている。
実際には、日々Markdownに貯めたネタをローカルLLMが下書きし、クラウドLLM・ローカルLLMとの質疑応答で内容を深めていく。クラウドAIに指示を出し、ローカルLLMに作業を任せる。戻ってきた結果をクラウドAIが確認し、私に報告してくれる。そんな役割分担が、今のところしっくりきている。
クラウドAIの有料コストを節約できているだけでなく、5時間リミットによる作業の中断もなくなったのが大きな変化だ。DoEditorの開発では制限に当たり、他社の20ドル契約を追加でした経験もあるが、重要な場面ではクラウドAIも有効で、必要な月だけ契約する考えだ。ローカルLLMには記事の執筆を手伝ってもらい、記事に挿入する画像はDraw Things CLIの画像生成モデルで作る。ローカルLLMと画像生成は別の道具だが、どちらも手元で使えるようになったことで、仕事の進め方が変わってきた。
道具に油を差したら、急に息を吹き返した日 #
とはいえ、相手は手のひらサイズの小さな箱だ。最初から何でもスラスラこなしてくれたわけではない。
Hugoの記事は、下書きを含めて116本。ショートコードなどを含めた総文字数は約88万字に及び、大まかに換算すると約22万トークン相当になる。今回の実験でローカルLLMに渡したのは記事全体ではなく、別の過去ログや資料から抽出した約3万トークン分だ。
ある日、溜まりに溜まった過去のログや資料(原稿用紙にしておよそ70〜80枚分、約3万トークンという長文データ)をMacに渡して、「ここから必要な要点だけを抜き出して整理してほしい」と頼んでみたことがある。
すると、途中でうんうんと唸ったままピタッと止まり、何も答えを出せなくなってしまった。
ローカルLLMの応答が遅いと、まだ処理中なのか、それとも失敗したのかが分からない。その判断がつかない時間は、思っていた以上に気持ちがしんどかった。性能に合ったモデルを選び、そのモデルが得意な仕事を任せることが大事なのだと感じた。
「やっぱり、クラウドの巨大サーバーと違って、机の上の小さなMacには荷が重かったか……」
だが、これは手仕事の道具なのだ。革包丁の刃が引っかかるなら、研ぎ直せばいい。
調べてみると、Ollamaのバージョンが少し古い(0.34.4)ままで、長文をうまく受け止める準備が整っていなかったことがわかった。そこで、新しいバージョン(0.40.5)へと更新してみた。
そして、もう一度同じ3万トークンの分厚い資料を渡してみる。
するとどうだろう。さっきまで固まっていたMacが、何事もなかったかのように滑らかに文章を読み進め、5分ほど経ったところで、指定した通りの整理された答えをポンと差し出してきたのだ。
性能表の数字よりも、「自分の手入れひとつで、昨日まで動かなかった機械が急に機嫌よく動き出した」という事実が、たまらなく嬉しかった。
5分間の静寂とコーヒー 一杯。 #
クラウドのAIが「10秒」で即答してくるのに対して、家のMacは3万トークンの書類を前にして「5分」ほど黙り込む。
ファンが微かに回りつつ、アルミの筐体をほんのり温めながら、静かに考え込んでいる5分間。
私はその間、席を立って台所へ行き、コーヒーを淹れる。湯気を眺めながらひと息ついて机に戻ると、ちょうど画面に「整理が終わりましたよ」とばかりに端正な文章が並んでいる。
この「5分間の余白」が、今の私の暮らしにはちょうどいい。
でも、コーヒーを淹れて一息つくはずが、次々と試したくなるAIの機能に、どうしても手が止まらない。休む暇もなく、また画面に張り付いてしまう自分がいる。
嫁ちゃん
わたし
夕食時、AIのことで頭がいっぱいで、そらちゃんがじっと見つめていることに気づかなかった。後になって、そらちゃんの存在を忘れていたことに気づき、「しまった」と申し訳なく思った。
せわしなく答えを求め、次から次へとタスクをこなすスピード勝負から少し降りて、道具が働く時間を待つ。その間に、自分自身の呼吸もふっと整う。
もしあなたの手元に、Mシリーズのチップが載ったMacがあるなら、流行りのサブスクを増やす前に、ぜひ一度試してみてほしい。
巨大な雲の向こうではなく、自分の机の上で、自分だけの道具が確かに息づいている手ざわり。それは、デジタルな日常を、思いのほか豊かに、そして穏やかにしてくれるはずだ。