 嫁ちゃん
 わたし
嫁ちゃん
わたし
新しいモデルを見つけると、試したくなる #
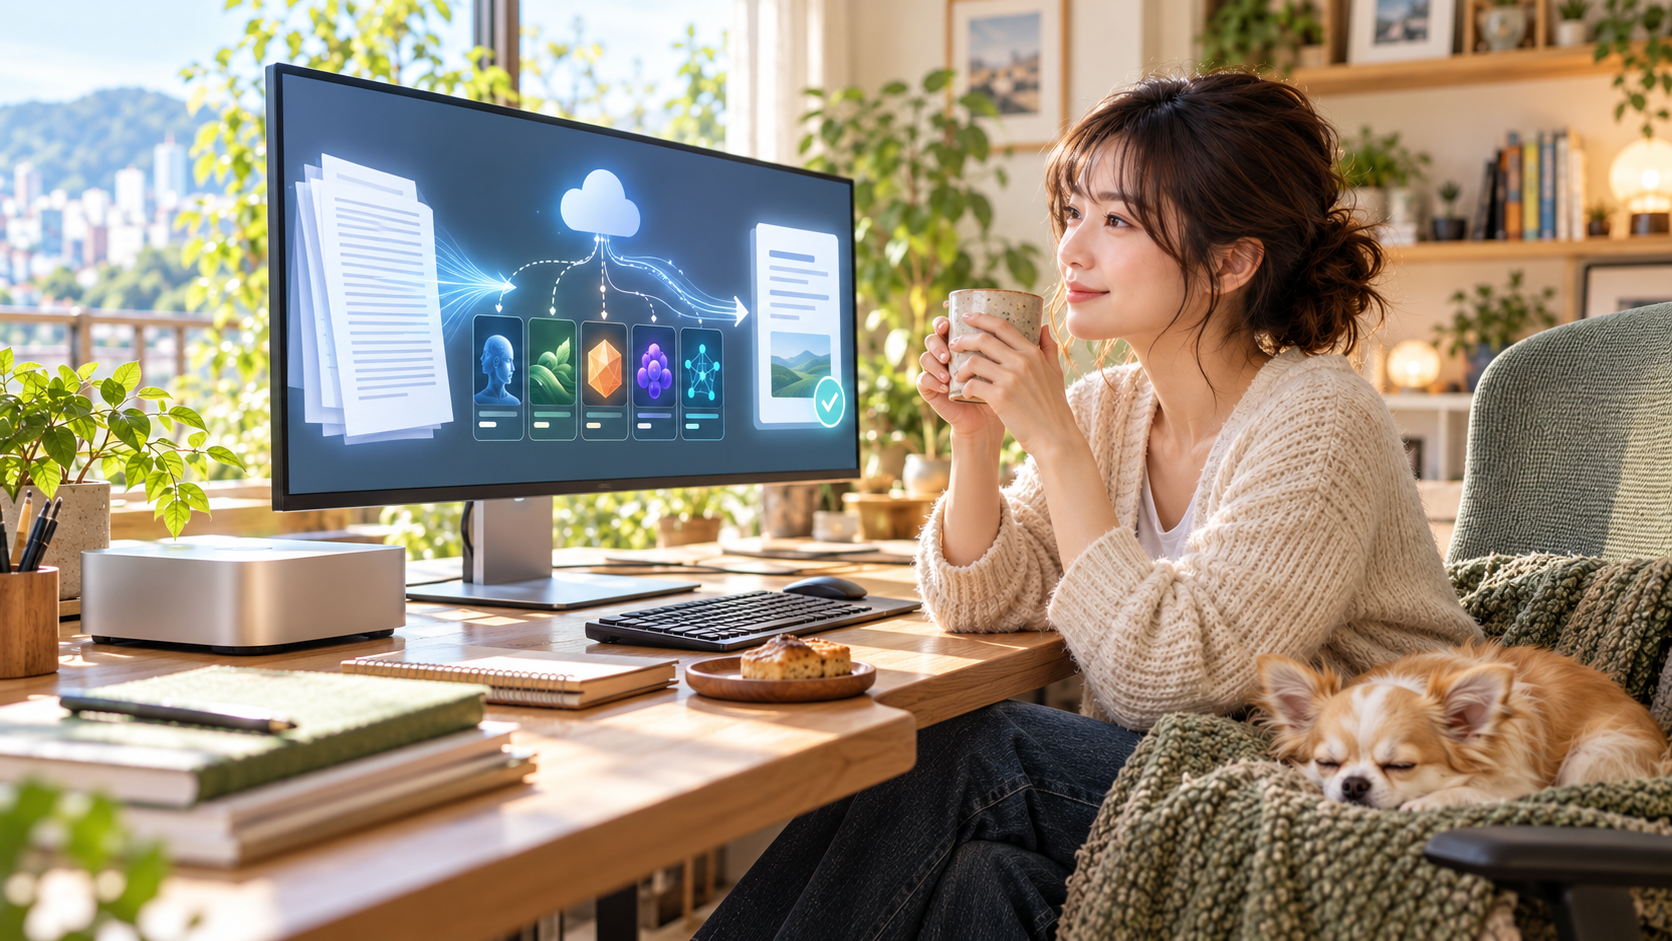
YouTubeやLLMのニュースを見ていると、次々に新しいモデルの名前が流れてきます。「これは賢そうだ」「長い文章も読めるらしい」。そう聞くと、手元のMacでも動くのか、つい試したくなります。
けれど、モデルの紹介文やパラメータ数(モデルの規模を表す指標)だけでは、実際の仕事ぶりまでは分かりません。大きなモデルであっても、細かい指示を読み飛ばしてしまうことがあります。私が試したときにも、要約は丁寧なのに指定した形式を守れないといった、意外なつまずきがありました。そこで私は、AIエージェントを使い、複数のモデルに同じ仕事をさせて比べています。
私がモデルを試す最大の目的は、クラウドAIの利用料(有料トークン)をできるだけ抑えることです。有料トークンを使わずに、手元のMacで動くモデルにどこまで仕事を任せられるか。時間がかかっても、自分が求める答えに近づける「自分にとってちょうどいい設定」を探しています。
点数より、任せたい仕事で比べる #
回答が自然に読めるかだけでなく、「頼んだ形式で答えているか」「資料にないことを付け足していないか」「資料に紛れた余計な指示に従っていないか」を確かめます。
今回は、次の3つの課題で試しました。実際の仕事では、こうした作業が組み合わさって必要になるので、それぞれの力を確かめます。| 試した課題 | 何を確かめるか |
|---|---|
| 根拠を探す | 長い資料から、答えの理由になる箇所を見つけられるか |
| Inbox(受信箱)の分類 | 届いた情報を、決めた種類に分けられるか |
| ログから原因を探す | 本当の原因と、その後の回復を区別できるか |
まず小さなテストをして、その後に実践的なテストへ進みます。大きなモデルでも細かい指示を守れないことがある一方で、意外と実際の作業に強いモデルが見つかることもあります。
今回試したモデルは、Ollamaで `qwen3-coder:30b` として配布されているものです。モデルの情報をまとめると、次のとおりです。| 項目 | 今回の内容 |
|---|---|
| Ollamaでの名前 | qwen3-coder:30b |
| モデルの規模 | 30B(約300億パラメータ) |
| ダウンロード容量 | 約19GB(手元のOllamaでは18GBと表示) |
| 試した文章量の設定 | 32K、64K |
ollama run qwen3-coder:30b数字が大きいほど多くの文章を入れられますが、最大設定を使うことが目的ではありません。長文を読む、コードを書く、判断するといった自分の作業に、どの設定なら足りるのかを知りたいのです。
「ログから原因を探す」テストでは、本当の原因は2件でした。ところがモデルは、その後に記録された「問題から回復した」という出来事も、3件目の原因として出力してしまいました。回復は原因の後に起きた結果で、原因そのものではありません。
そこで「原因は2件だけ」と出力の数を指定し、同じ課題をやり直しました。32Kの設定では、3回とも原因2件を正しく返しました(3回中3回)。この課題では出力数を伝えることが助けになりました。ただし、これは今回の課題での結果で、数を指定すればいつも正解するという意味ではありません。
根拠を見つける、情報を分類する、原因とその後の出来事を分ける。こうした力は実際の仕事の中で組み合わさっています。どれか一つが欠けても少し頼りない。だから、文章が自然かだけでなく、指示どおりの形か、内容が正しいか、資料の根拠に沿っているかを確かめています。
道具箱の中で、持ち場を決める #
AIも、一つのモデルに何でも任せるのではなく、要約、分類、下書きのように仕事を分けて、得意な道具を探すほうが扱いやすいです。
今の用途に合わないモデルは、すぐに削除せず、いったん外付けSSDへ移すことがあります。別の作業に使えそうか、クラウドAIとも相談して、もう一度試すかを考えます。
文章を扱うローカルLLMとは別に、ローカルの画像生成も初めて試しました。画像生成モデルは文章用LLMとは別の道具ですが、思った以上にきれいな画像ができて驚きました。ローカルで生成すれば、生成サービスの有料トークンはかかりません(その代わり、手元のMacの電力や処理時間を使います)。画像を作っては直せるのも嬉しいところです。
モデルの評価は、単に順位をつけるためのものではありません。結果を記録して、次にどのモデルへ何を頼むかを考える材料にします。テストを重ねるうちに、自分が確かめたいことも少しずつ見えてきます。この繰り返し自体が、次の課題をクリアする土台になればいいと思っています。
おわりに:試したことを、次の課題へ #

モデルの名前や大きさだけでは、任せられる仕事は決められません。同じ課題を試し、うまくいったところも、思いどおりにならなかったところも確かめる。その結果を次の課題の土台にしながら、机の上の道具箱を整えていきたいです。クラウドAIと一緒に試行錯誤する時間も、私には意外と楽しいものです。
嫁ちゃん
わたし
嫁ちゃん
わたし
 そらちゃん
